Johnny PLATON.

Senior Data & AI Engineer (11+ ans d’expérience)

Diplômé en Mathématiques appliquées et Modélisation, j'évolue actuellement dans le secteur de la santé publique. Passionné par l'ingénierie des données et l'IA appliquée, je conçois des solutions end-to-end pour transformer des flux complexes en outils décisionnels. J'articule architecture de données robuste (PostgreSQL, Big Data) et déploiement de modèles NLP/MLOps en production. Mon approche : traduire des enjeux business complexes en pipelines de données performants, fiables et maintenables.

Photo de John

Projets

« Concevoir des architectures légères, utiles et directement déployables, tout en résolvant des problèmes métiers mesurables. »

Ce portfolio est articulé en deux volets :

  • Applications IA & Full-Stack (3 projets) : Des services en production réinventant des usages du quotidien — cinéma, mobilité, messagerie — appuyés sur des architectures modernes (FastAPI, RAG, pgvector, LLM).
  • Data Science & MLOps (2 projets) : Des moteurs d'analyse orientés métiers (prévision de stocks, détection d'anomalies/fraude) basés sur du Machine Learning appliqué.

Chaque projet repose sur des jeux de données publics ou synthétiques , conteneurisé via Docker et déployé sur une infrastructure Cloud agnostique pour garantir une reproductibilité totale, une isolation stricte des dépendances et une maîtrise optimale des coûts d'hébergement.

ℹ️ Note sur l'accès aux démos : Les applications sont hébergées sur une infrastructure cloud optimisée (Render free tier) qui met les conteneurs en veille hors utilisation. Le premier accès à un projet peut prendre 30 à 50 secondes le temps de réactiver le service.

1. Systèmes & Applications IA Déployées

Applications basées sur l'IA générative et la recherche sémantique : architectures RAG, pipelines d'embeddings, bases vectorielles et interfaces conversationnelles.

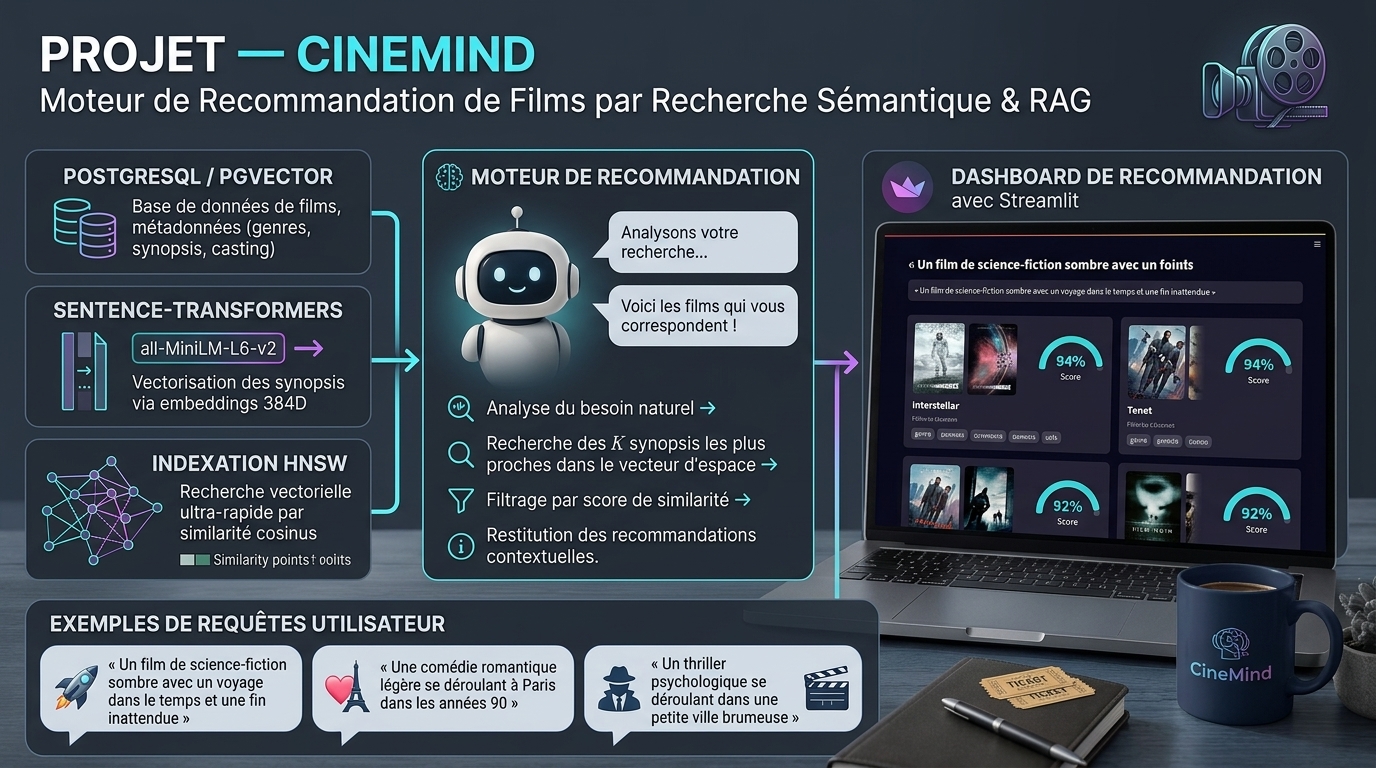
CineMind — Moteur de Recommandation RAG

Python PostgreSQL / pgvector Streamlit uv

Application de recommandation de films basée sur la recherche de similarité vectorielle en langage naturel.

Points clés de l'architecture :

  • Vectorisation des synopsis via embeddings 384 dimensions (all-MiniLM-L6-v2).
  • Stockage et indexation haute performance avec pgvector et index HNSW.
  • Déploiement managé sur le cloud.
  • Gestion de l'environnement Python optimisée avec uv.

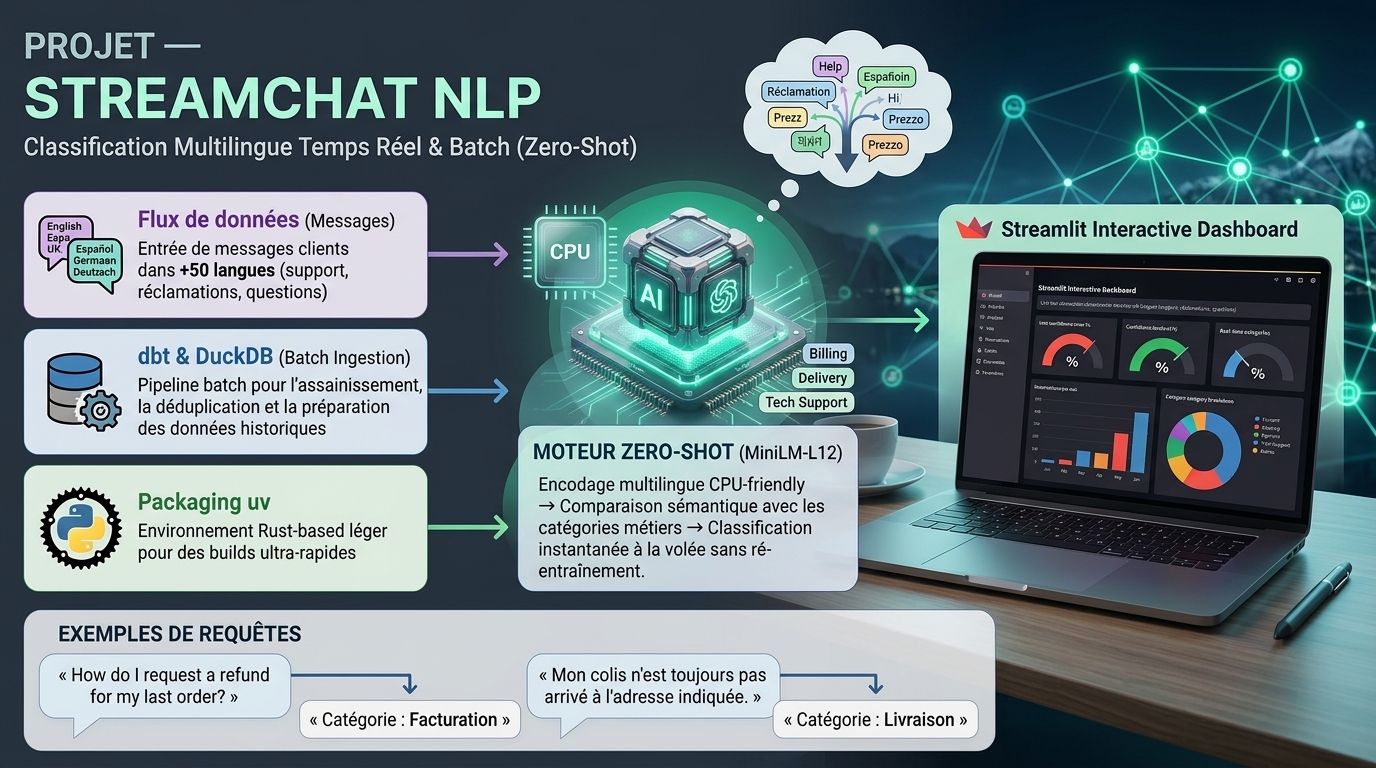
StreamChat NLP — Classification Multilingue Temps Réel & Batch

Python / uv Sentence-Transformers dbt / DuckDB Streamlit / Cloud

Plateforme MLOps permettant de catégoriser automatiquement des messages clients dans plus de 50 langues. Conçue pour offrir un traitement rapide et léger sur CPU, sans la latence ni les coûts des gros modèles de langage (LLMs).

Points clés de l'architecture :

  • Classification Zero-Shot : Modèle multilingue léger (MiniLM-L12) permettant d'ajouter ou modifier les catégories métiers à la volée sans aucun ré-entraînement.
  • Architecture Hybride (Batch & Online) : Mode temps réel pour les messages unitaires et pipeline dbt / DuckDB pour l'assainissement et la déduplication de volumes historiques.
  • Pragmatique & Économique : Alternative sobre aux APIs LLM payantes, optimisée pour minimiser les coûts d'infrastructure.
  • Industrialisation Modernisée : Environnement géré via uv, conteneurisation Docker et CI/CD automatisée sous GitHub Actions.

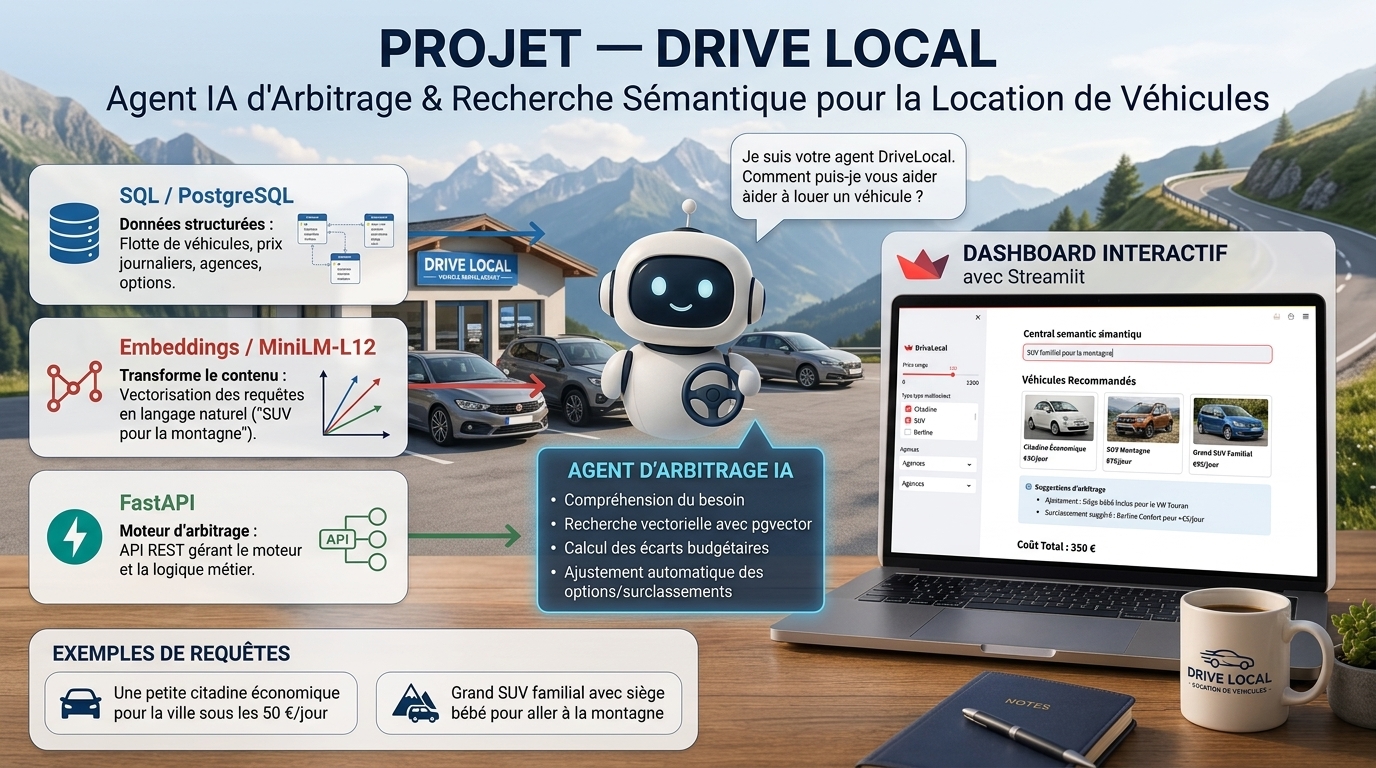
DriveLocal — Agent IA d'Arbitrage & Recherche Sémantique SaaS

Python / uv FastAPI PostgreSQL / pgvector Streamlit / Docker

Plateforme SaaS de recherche de véhicules de location permettant d'aligner les intentions exprimées en langage naturel avec les contraintes budgétaires réelles.

Points clés de l'architecture :

  • Recherche Vectorielle Multilingue : Embeddings MiniLM-L12 couplés à pgvector.
  • Moteur d'Arbitrage Métier : Logique décisionnelle embarquée analysant l'écart budgétaire pour proposer des alternatives économiques.
  • Architecture Microservices : Découplage complet API (FastAPI) et Frontend (Streamlit) conteneurisés indépendamment sous Docker.
  • Déploiement Cloud & Auto-Seeding : Pipeline hébergé sur un environnement Cloud avec initialisation automatique du schéma SQL.

2. Data Science & Impact métier

Études de cas en Data Science : ingénierie de variables, benchmarking d'algorithmes et optimisation de seuils décisionnels pour la détection et la prévision.

Prévision de la demande & optimisation des stocks (Supply Chain)

Python / uv LightGBM SHAP Streamlit / CI-CD

Modèle d'optimisation de stock visant à minimiser le coût financier global (arbitrage invendus vs ruptures).

Points clés de la démarche :

  • Feature Engineering temporel : Création de lags et variables glissantes sans fuite de données (Data Leakage).
  • Modélisation & Benchmarking : Comparaison d'un modèle LightGBM par rapport à une baseline de moyenne mobile.
  • Explicabilité métier : Interprétation fine des facteurs d'influence (saisonnalité, promotions) via SHAP values.
  • Simulateur financier : Dashboard interactif calculant le stock de sécurité (Safety Stock Buffer) optimal pour maximiser le gain net en euros.

AnomalyEngine — Détection d'anomalies & arbitrage financier

Python / uv Scikit-Learn XGBoost / Isolation Forest SHAP

Modèle de détection d'anomalies multi-domaines (Fintech, IoT, SaaS) orienté sur l'optimisation financière du seuil de décision (arbitrage fausses alertes vs anomalies manquées).

Points clés de la démarche :

  • Feature Engineering & Prétraitement : Calcul de métriques glissantes, de volatilité et d'écarts aux comportements nominaux, adaptées à la détection de ruptures de comportement.
  • Modélisation & Benchmarking : Alignement du seuil de probabilité sur le coût réel d'un Faux Négatif (client perdu) vs Faux Positif (campagne inutile).
  • Explicabilité globale & locale : Analyse fine des facteurs déclencheurs d'alertes via SHAP values (Beeswarm plot global et Waterfall plots comparatifs sur cas sains vs anormaux).
  • Arbitrage coût/seuil : Simulation interactive recherchant le seuil de probabilité optimal minimisant la matrice de coûts métier pour maximiser le gain net.

Compétences & Expertise

01.

IA & NLP / Search

Transformers, LLM, RAG, Embeddings, Recherche vectorielle (pgvector, HNSW), PyTorch, Scikit-learn, Statistiques & Modélisation.

02.

Data Engineering & SQL

PostgreSQL, Modélisation de données, PySpark / Scala (Certifié), DuckDB, Airflow, Pipeline ETL/ELT, SQL avancé.

03.

MLOps, Tooling & Deploy

Python (Expert), Docker, uv, Git / GitLab-CI, Streamlit, Déploiement Cloud, API REST.

Me contacter

Échangeons autour de la Data et l'IA. Une question sur la méthodologie ou le code ? Discutons-en.